Metaとオックスフォード大学の研究チームは、シーンを視点の連なりとして生成するモデルAVMを発表しました。点群やメッシュといった3Dの形状データは作らず、2Dの映像の流れだけでシーンを表現します。(※点群:物体の表面を点の集まりで表したデータ)(※メッシュ:多角形の面を組み合わせて立体を表すデータ)
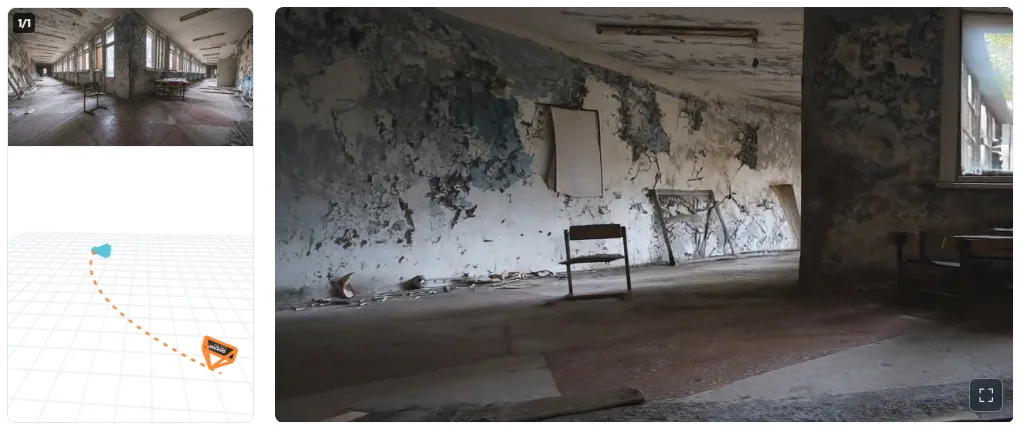
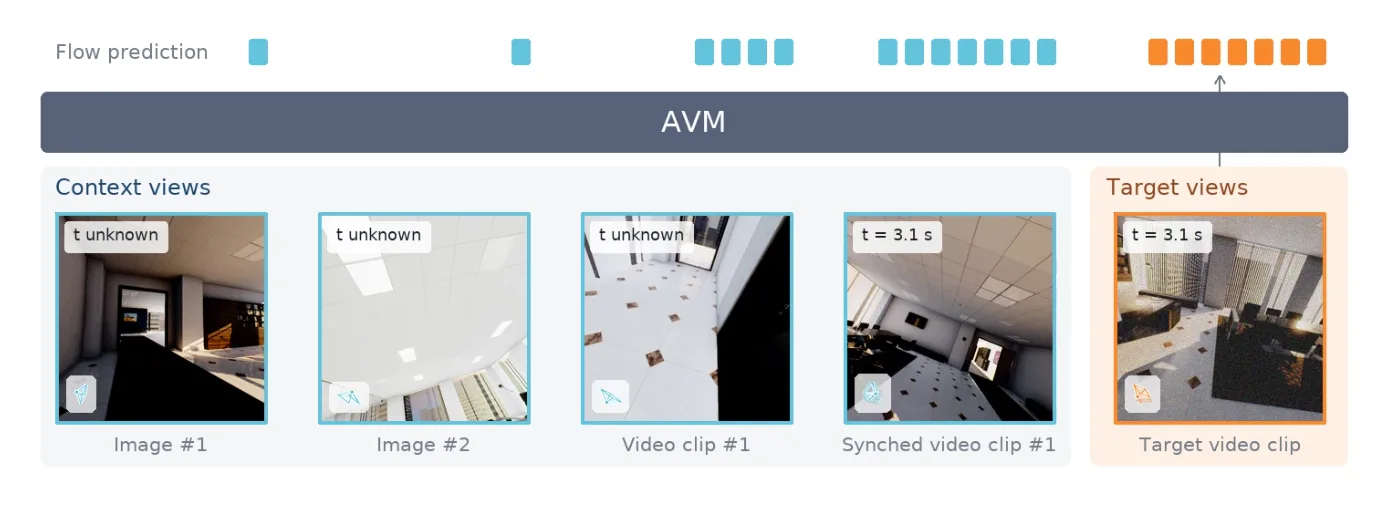
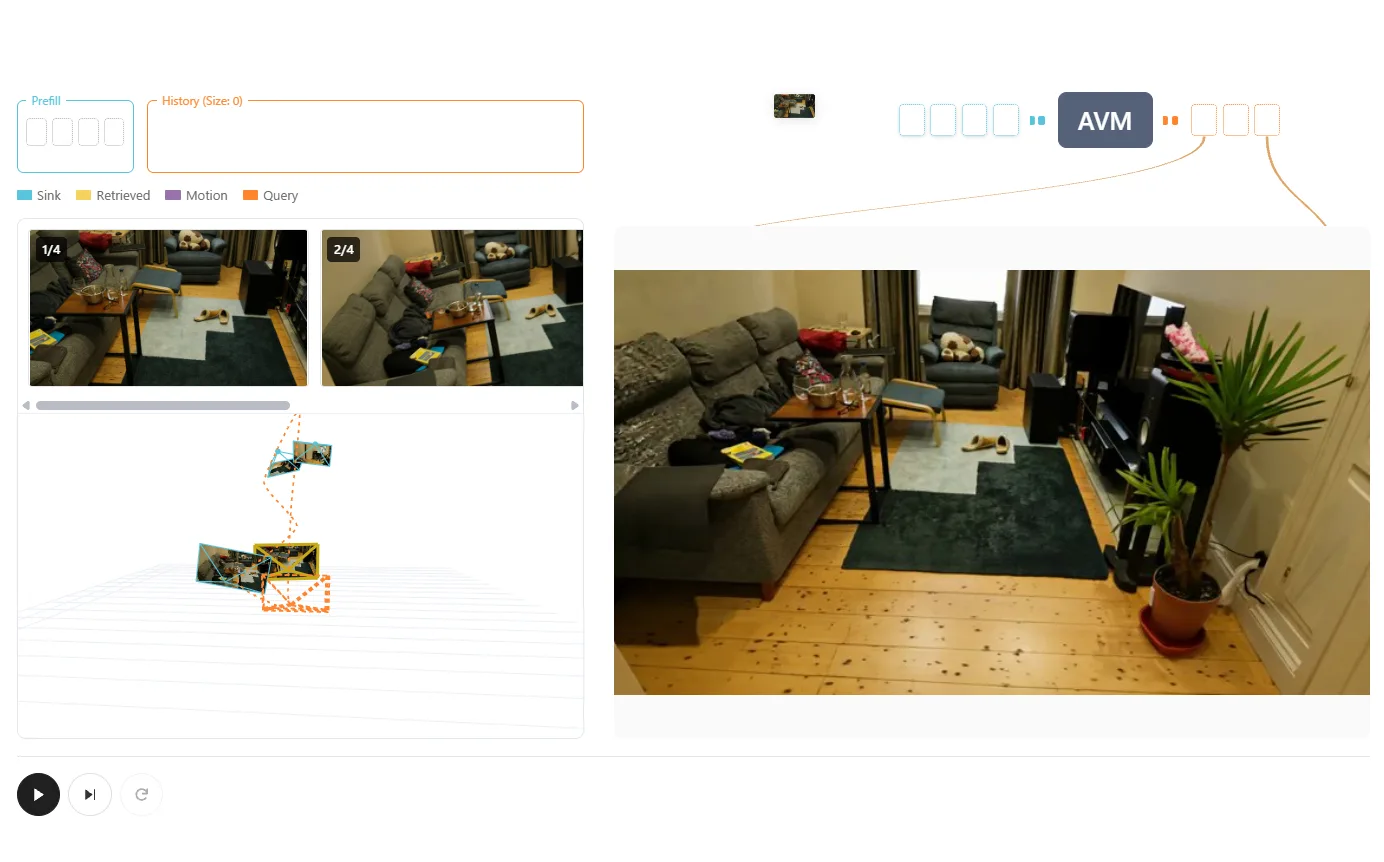
生成の手順は言語モデルと同じ考え方に基づいています。画像や動画などの空間情報を先に読み込んだうえで、視点の映像を短いまとまりごとに順番に生成する仕組みです。各視点にはカメラの位置と時刻がひもづけられています。
入力には複数の画像、1本の動画、複数のカメラで同期撮影した映像を使用可能です。動画を入力すれば、元のカメラが撮っていない角度から人の動きを映し直せます。開発チームは、実際のカメラの間の角度からプレーを見せるスポーツ中継への応用も挙げました。
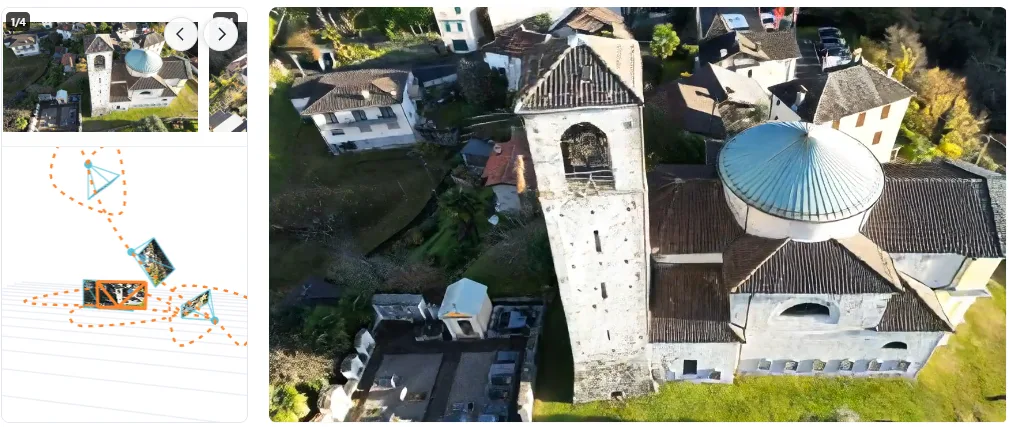
AVMは、カメラが遠くへ移動したあと元の場所に戻っても、以前の映像を参照して物の配置や見た目を保ちます。テキストでの指示にも対応しており、カメラの移動に合わせて新たに現れる空間や出来事を指定できます。
NeRFやガウシアン・スプラッティングで使う高密度の撮影データも入力に使えます。シーンごとに別の表現を作り込む工程を経ずに、新しい視点の生成を始められます。現時点では映像に乱れが残るものの、モデルとデータの規模拡大で品質が上がると開発チームは見込んでいます。(※NeRF:多視点の写真からシーンを再現する手法)
性能評価では、カメラ操作の正確さを測るWorldScoreのカメラスコアで70.67を記録しました。比較対象のSEVAは68.94です。動きのあるシーンを別視点から再現する4D再構成の指標でも21.16となり、ReCamMasterの13.53を上回っています。
参考
AVM: Generating a scene as a stream of views